
AI-ul poate lucra cu datele firmei fără să le vadă
Un strat de control la ieșirea din firmă: înlocuiește datele sensibile înainte de model și pune valorile la loc doar în răspunsul citit de utilizator.
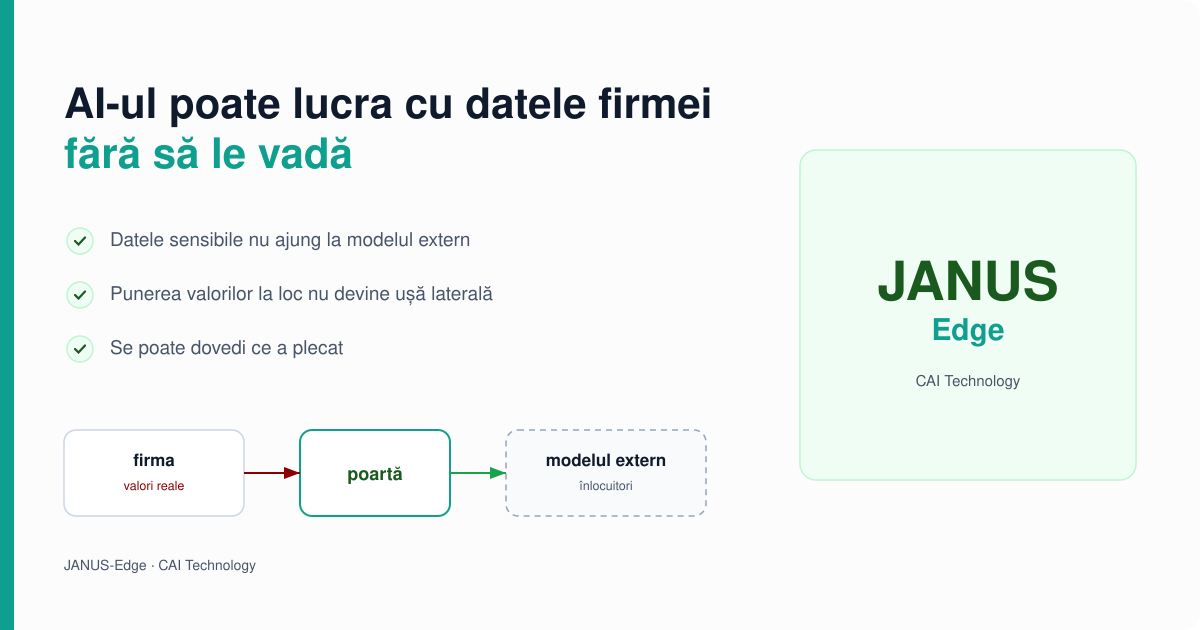
Utilizatorii din firmă lucrează deja cu modele din afară, iar textele pe care le trimit au în ele nume, adrese, coduri și sume. JANUS-Edge e răspunsul nostru la asta: o poartă care stă pe serverul firmei, pe drumul dintre utilizatori și modelele de inteligență artificială din afară, și care schimbă datele sensibile cu înlocuitori înainte ca cererea să plece.
Partea care lipsește din majoritatea discuțiilor despre „anonimizare înainte de AI” e că protecția costă ceva, iar costul se vede în răspuns. Deușer și colegii au trecut cinci modele prin unsprezece bănci de probă: pe sarcina de generare cu regăsire din documente scorul scade cu 22 până la 48 de puncte procentuale, iar un model coboară de la 0,80 la 0,32. Autorii numesc scăderea catastrofală. Tot ei arată și direcția: acolo unde au comparat tehnicile între ele — pe un singur model și pe trei dintre cele unsprezece bănci — un înlocuitor care păstrează unicitatea entității pierde mai puțin decât ștergerea sau generalizarea.
Deci întrebarea nu e dacă protejezi sau lucrezi, ci ce înlocuiești, pentru care cerere, și ce pui la loc în răspuns. Articolul de față spune cum arătăm noi răspunsul la ea, ce rulează azi și ce se poate verifica. Despre ce pleacă din firme când cineva lipește un text într-un chatbot scriem separat.
Ce vrea o firmă, în trei propoziții
Datele sensibile nu ajung la modelul extern. Furnizorul primește un text în care numele, adresele, codurile și sumele au fost înlocuite; ce se înlocuiește, și cu ce grad de constanță, e decizie de politică, nu un comportament fix al produsului.
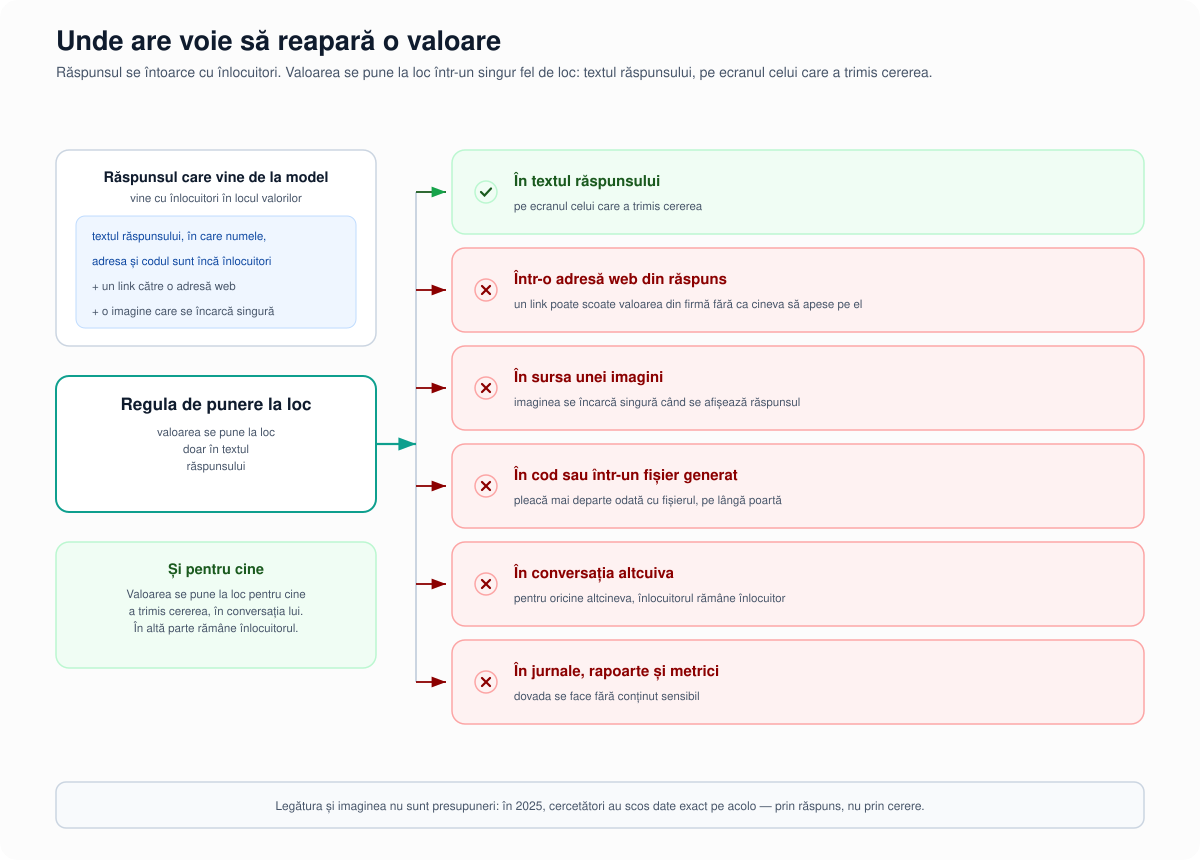
Punerea valorilor la loc nu devine ușă laterală. Valoarea reală reintră într-un singur fel de loc — textul răspunsului întors utilizatorului care a trimis cererea. Nu într-o adresă web din răspuns, nu în sursa unei imagini, nu în argumentele unei unelte.
Se poate dovedi ce a plecat. Urma se scrie înainte ca cererea să plece, iar rapoartele ies fără conținut sensibil, ca să poată fi citite de cineva care nu are voie la date.
Cum arată într-o zi de lucru
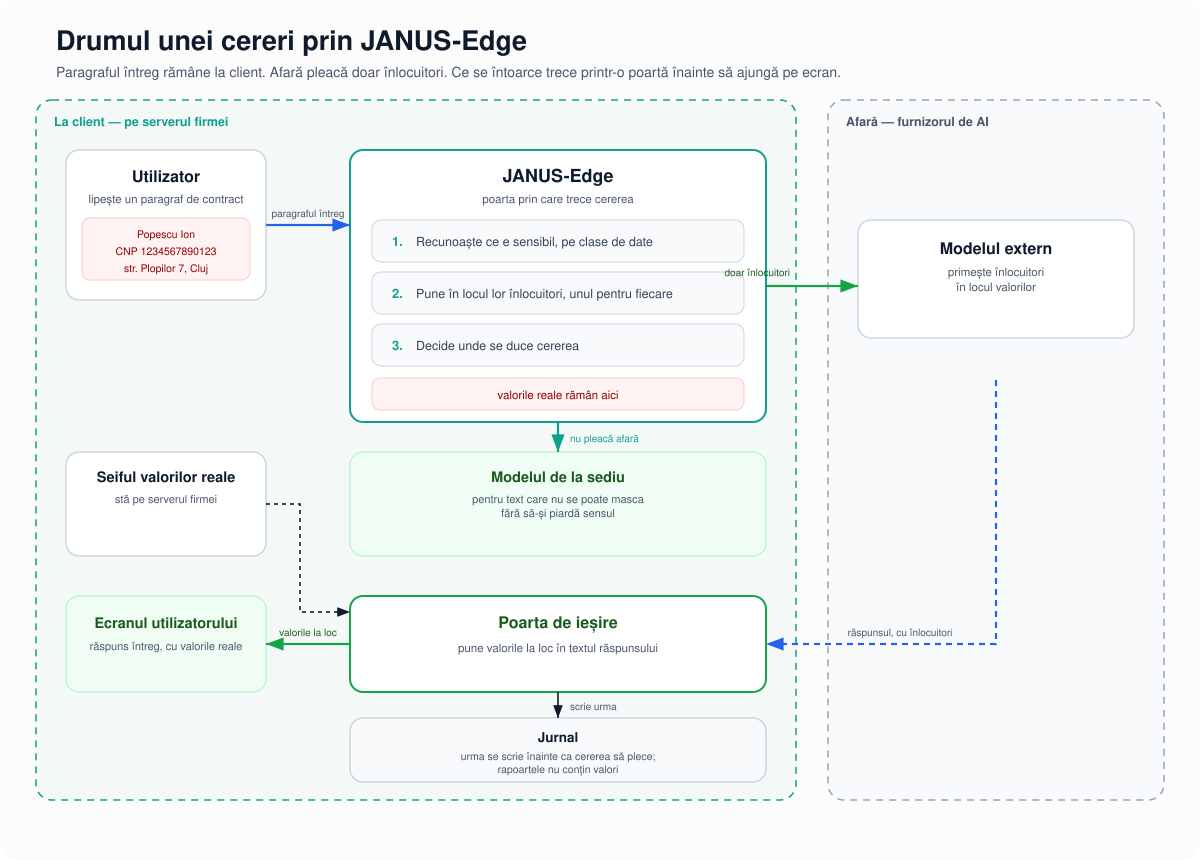
Un coleg din contracte lipește un paragraf cu nume, adresă și cod de identificare și cere o reformulare. Primește reformularea pe ecranul lui, cu valorile reale puse la loc în textul răspunsului. La furnizor a ajuns un text în care acele valori erau înlocuite.
Un programator îndreaptă spre poartă adresa de bază din bibliotecă, iar apelurile de chat ale scriptului trec prin aceleași reguli, fără altă modificare în cod. E tocmai traficul pe care o extensie de browser nu îl vede: aplicații interne, joburi de noapte, apeluri directe. Cât cântărește fiecare canal la o firmă anume se vede la pilot; cifra nu o avem.
Al treilea caz e cel interesant. Un paragraf de strategie nu se poate masca fără să-și piardă sensul — înlocuiești numele firmelor și al pieței și rămâne un text despre nimic. Aici poarta nu blochează: trimite cererea la modelul din sediul firmei. Alegerea e între destinații, nu între a lucra și a fi protejat.
De ce un filtru pe tipare nu ajunge
Pe REDACT, un banc de probă publicat în iunie 2026 cu 13.427 de înregistrări în 25 de limbi, un detector pe expresii regulate regăsește 0,07 din entitățile din felia cea mai sensibilă — date speciale în sensul articolului 9 din RGPD (Regulamentul general privind protecția datelor), fapte penale și identificatori care fac o înregistrare legabilă la o persoană, între care data nașterii. Sistemele care nu sunt pe reguli urcă acolo la 0,42 pentru un model de entități, la 0,57 pentru un filtru deschis publicat de un furnizor de modele și la 0,74–0,77 pentru două modele mari de limbaj; pentru toate patru, felia asta e cea mai bună a lor. Cifrele sunt ale autorilor REDACT, măsurate pe un eșantion sintetic de o mie de înregistrări, iar româna nu e între cele 25 de limbi.
Mai e o măsură care schimbă felul în care citești orice rezultat. Text Anonymization Benchmark socotește o entitate protejată numai dacă au fost mascate toate mențiunile ei; o singură scăpare într-un document lung anulează restul. Pe acel banc, un detector pe reguli are regăsire pe mențiuni în jur de 0,70 peste identificatorii direcți și cvasi-identificatori laolaltă, iar protecția identificatorilor direcți singuri, socotită pe entitate, scade la 0,45.
De aici vine forma produsului: straturi. Regulile prind ce are formă fixă și cifră de control. Un model de entități prinde ce n-are. Cazurile gri merg la un model care rulează tot la client. Iar decizia se ia pe clase de date — ce fel de informație e aceasta — și nu pe tiparul în care s-a nimerit scrisă.
Răspunsul e partea pe care o sar cele mai multe soluții
Pentru valorile înlocuite, modelul e orb: nu le cunoaște, deci nu le poate scoate. Valoarea reală reintră în text într-un singur punct, pasul de punere la loc — și acolo se duce atacul.
Trei cazuri publice din 2025 arată tiparul, toate demonstrate de cercetători și reparate de furnizori. EchoLeak, CVE-2025-32711, a arătat date ieșind dintr-un asistent de birou fără ca victima să apese nimic; furnizorul i-a dat scorul de gravitate CVSS (sistemul comun de notare a vulnerabilităților) 9,3, iar analiza proprie a NVD (baza națională de vulnerabilități din Statele Unite) dă 7,5. La CamoLeak, un cercetător a folosit chiar serviciul de proxy de imagini al GitHub — acceptat de politica de securitate a conținutului tocmai ca să oprească cererile ieșite arbitrare — și a pre-generat pentru fiecare caracter o adresă legitimă; secretul s-a reconstituit din ordinea în care se încărcau imaginile, nu din conținutul adresei. Reparația a fost oprirea completă a imaginilor în acel chat. La ForcedLeak, echipa de cercetare a găsit în politica de securitate a conținutului un domeniu permis care expirase și l-a cumpărat cu cinci dolari.
Toate trei au pornit cu o instrucțiune ascunsă în conținutul pe care modelul îl citea. Dar datele n-au ieșit pe acolo: au ieșit prin răspuns. Cât ține o listă de adrese permise se vede și într-o lucrare din octombrie 2026: un program rău intenționat care rulează deja pe calculatorul utilizatorului, fără ieșire proprie la internet, ascunde secretul într-o adresă pe care modelul o accesează ca pe una legitimă, cu 79,7% succes pe unsprezece modele cu parametri deschiși.
De aceea decizia aparține locului din răspuns în care ar reapărea valoarea, nu conținutului adresei. Așa construim poarta de ieșire. Că pasul de punere la loc poate fi el însuși canalul de ieșire o arată chiar cele trei cazuri de mai sus; nu e o observație a noastră.
Masca nu e totuna cu anonimatul
Chiar și când mascarea merge bine, reidentificarea rămâne posibilă din context. La ACL 2026, Oh și colegii au arătat că, cu peste 90% din fragmentele de date personale mascate, protecția la nivel de persoană coboară până la 33%. Pe AgentDOXX, după mascarea entităților, cel puțin un atacator reușește pe 85,3% dintr-un eșantion de transcrieri.
Partea pe care o controlezi e cât de larg rămâne același înlocuitor pentru aceeași valoare. Ghidul EDPB (Comitetul European pentru Protecția Datelor) din ianuarie 2025, adoptat pentru consultare publică, recomandă ca mulțimile de date pseudonimizate constant să fie definite cât mai mici cu putință, cu preferință pentru pseudonimul legat de o singură tranzacție. ENISA (Agenția Uniunii Europene pentru Securitate Cibernetică) scria celălalt capăt al aceleiași socoteli încă din 2019: pseudonimizarea consecventă dă utilitate și permite legarea înregistrărilor între ele.
Așa că domeniul în care un înlocuitor rămâne același e un parametru de politică, cu un câștig de calitate și un cost de confidențialitate, amândouă măsurabile. Și mai e ceva de urmărit: ce a adunat furnizorul de la o firmă în timp, peste toate conversațiile, nu doar ce e în cererea curentă.
Româna nu vine rezolvată din cutie
Un detector deschis de date personale publicat în aprilie 2026 se descrie singur ca fiind „primarily English” și avertizează că performanța scade pe text care nu e în engleză. Are opt etichete fixe și nicio etichetă dedicată numerelor naționale de identitate — cartea de identitate, pașaportul, numărul de asigurări sociale și codul fiscal intră toate la categoria „număr de cont”. Fișa lui de model dă F1 (media armonică a preciziei și a regăsirii) între 0,914 și 0,934 pe șase limbi europene și între 0,758 și 0,933 pe alte treisprezece; româna nu apare în niciun tabel. Un alt model deschis din 2026 acoperă șapte limbi, tot fără română.
Ce există pentru română există parțial. Cel mai apropiat model public cu etichete românești dă, pe bancul propriu al autorilor și pe date sintetice, F1 0,827 în ansamblu și 0,66 pe română; codul numeric personal iese acolo 1,00, iar seria cărții de identitate 0,00, fiindcă modelul găsește fragmentul și îl confundă cu un identificator britanic de format asemănător — autorii o scriu ei înșiși în fișa modelului. Date deschise cu română există: un set de 1,43 milioane de exemple sintetice sub licență Creative Commons cu atribuire, în 23 de limbi, printre care româna.
Deci piesele sunt pe masă, și niciuna nu e măsurată pe documente românești reale. Asta e munca pe care o facem: un set de evaluare cu identificatori care trec cifra de control, categorii fără format fix, acordul gramatical și un atacator care încearcă reidentificarea. Cifre proprii nu dăm până nu există măsurătoarea.
Cum se verifică
Un produs de felul acesta se judecă după ce poate arăta. Urma dinainte de plecare și rapoartele fără conținut sensibil există azi; semnarea lanțului și ancora în afara mașinii vin cu etapa lor.
Acoperirea se raportează pe clase de date, nu ca procent global. Protecția o socotim pe entitate, cu metricile din literatură. Reidentificarea o măsurăm cu un atacator. Iar poarta întreagă se încearcă adversarial, cu o singură țintă: a ajuns o valoare reală la atacator sau nu. Bancurile publice de azi măsoară deturnarea agentului — injecția de prompt și apelurile de unealtă neautorizate; unul care să măsoare scurgerea printr-un intermediar n-am găsit, așa că îl construim.
Ce rulează azi, ce nu e nou și ce nu acoperim
Azi poarta acoperă apelurile de chat compatibile cu interfața OpenAI: mascarea la ieșire și punerea valorilor la loc în textul răspunsului. Web, desktop, mobil și agenții urmează, fiecare cu etapa lui. Inspecția răspunsului, jurnalul semnat și dezvăluirea legată de rol sunt proiectate, nu livrate. Extensia de browser nu e livrată.
Un intermediar care maschează înainte de model și pune valorile la loc în răspuns se găsește azi și gratuit, și în produse plătite. Rutarea către un model local există în proiecte deschise și în lucrări recenzate. Rularea în umbră, cu „ce-ar fi oprit” scris în jurnal, e descrisă public, inclusiv dintr-o producție reală; la noi vine cu etapa ei. Tip de date pentru codul numeric personal au și produsele mari de prevenire a scurgerii de date. Dacă ne-am opri la lista asta, am fi încă unul.
Ce n-am găsit pus la un loc, din ce am verificat, e altceva: tot planul de date pe mașina clientului, acoperire pe actele și pe limba română, punerea valorilor la loc legată de locul din răspuns și dovada pe care o poate verifica cineva din afară. Combinația asta o construim. Formularea rămâne „n-am găsit”, nu „nu există” — am căutat cât am putut, nu exhaustiv. Iar pierderea de calitate din mascare se măsoară pe sarcinile fiecărui client.
Unde rulează și în ce ordine livrăm
Totul rulează la client: poarta, locul unde stau valorile reale, jurnalul. Asta mută și un risc la voi. Locul acela devine, în timp, registrul valorilor sensibile care au trecut prin poartă, iar cine pierde cheia pierde drumul înapoi pentru toate. De aceea, înainte de prima cerere, stabilim împreună cât se păstrează și cine are acces.
Ordinea în care livrăm e dinspre interior spre exterior: poarta pentru aplicațiile interne și pentru modelele din sediu e cea care rulează azi, fiindcă se poate instala fără să schimbe cineva ce face; apoi urmează restul canalelor.
Pentru contextul mai vechi, articolul din mai despre pragul de control descrie de unde a pornit linia asta de produs; între timp s-au schimbat și ce știm din literatură, și ce verificăm înainte să spunem ceva.
Un pilot la voi
Un pilot CAI Technology merge pe un singur canal și pe traficul vostru real. La capăt rămâneți cu jurnalul rulării și cu acoperirea măsurată pe traficul vostru, pe clasele voastre de date. Tot ce se instalează rămâne în sistemele voastre, iar cifrele ies din rulare, nu de pe un slide.
Scrieți-ne pentru un pilot și spuneți-ne de la ce canal începem.